Visual Generative ModelsBenchmarks & Surveys
Maijunxian Wang*, Ruisi Wang*, Juyi Lin*, Ran Ji*, …, Qianli Ma, …,
Zhongang Cai†, Hokin Deng†
All 56 authors
Maijunxian Wang*, Ruisi Wang*, Juyi Lin*, Ran Ji*, Thaddäus Wiedemer, Qingying
Gao, Dezhi Luo, Yaoyao Qian, Lianyu Huang, Zelong Hong, Jiahui Ge,
Qianli Ma, Hang He, Yifan Zhou, Lingzi Guo, Lantao Mei, Jiachen
Li, Hanwen Xing, Tianqi Zhao, Fengyuan Yu, Weihang Xiao, Yizheng Jiao, Jianheng
Hou, Danyang Zhang, Pengcheng Xu, Boyang Zhong, Zehong Zhao, Gaoyun Fang, John
Kitaoka, Yile Xu, Hua Xu, Kenton Blacutt, Tin Nguyen, Siyuan Song, Haoran Sun,
Shaoyue Wen, Linyang He, Runming Wang, Yanzhi Wang, Mengyue Yang, Ziqiao Ma,
Raphaël Millière, Freda Shi, Nuno Vasconcelos, Daniel Khashabi, Alan Yuille, Yilun
Du, Ziming Liu, Bo Li, Dahua Lin, Ziwei Liu, Vikash Kumar, Yijiang Li, Lei Yang,
Zhongang Cai†, Hokin Deng†
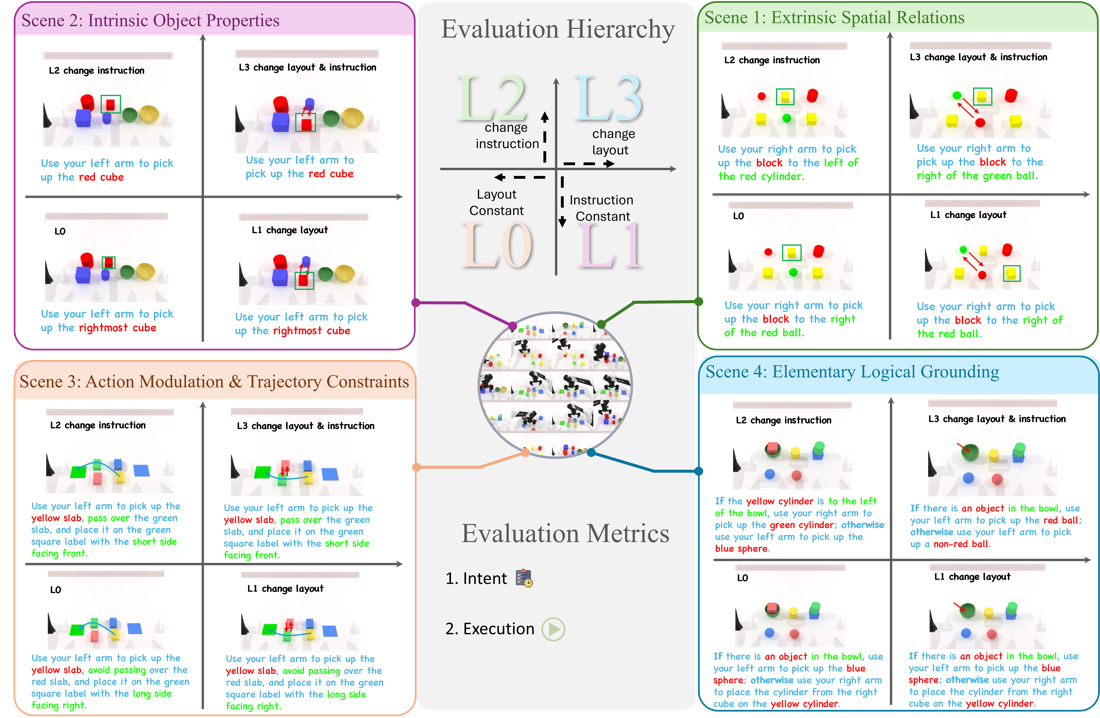
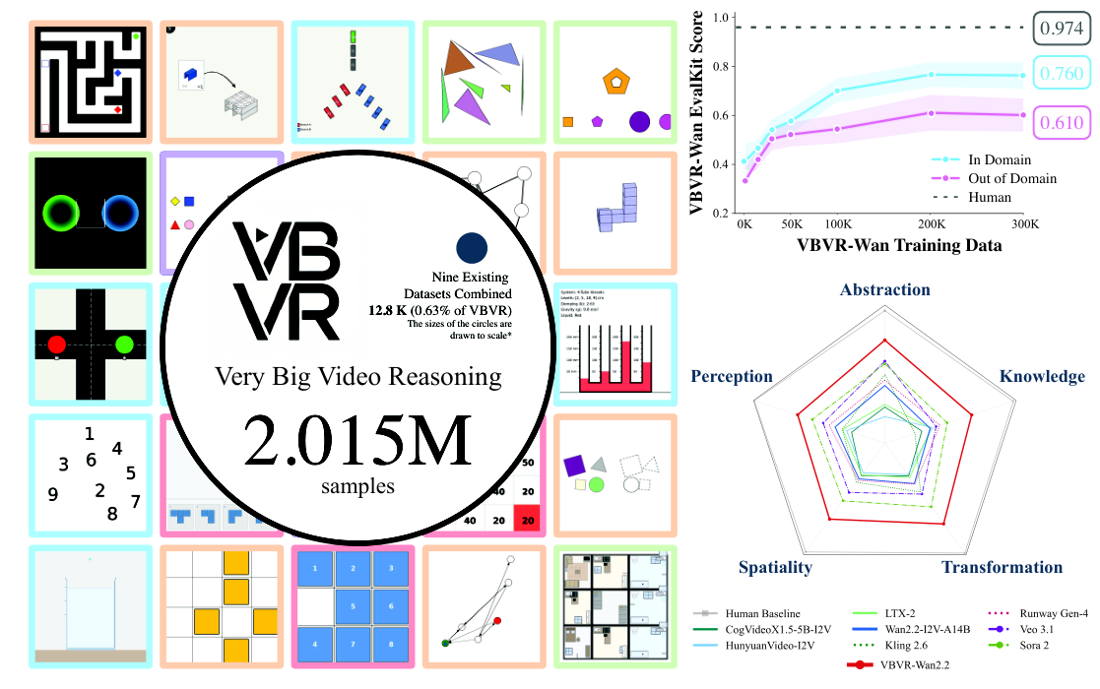
A large-scale suite for video reasoning, pairing diverse training tasks with
verifiable evaluation and a systematic study of reasoning generalization.